Stellen Sie sich vor, Sie haben einen brillanten neuen Mitarbeiter eingestellt. Er ist eloquent, kann komplexe Zusammenhänge erklären und spricht mehrere Sprachen fliessend. Aber er kennt Ihr Unternehmen nicht. Er weiss nichts über Ihre Produkte, Ihre internen Prozesse oder Ihre Kundenhistorie. Genau das ist das Problem mit Large Language Models (LLMs) wie GPT-5.6 oder Claude: Sie sind unglaublich leistungsfähig, aber sie kennen Ihre Unternehmensdaten nicht.
Retrieval-Augmented Generation – kurz RAG – löst dieses Problem. RAG ist die Technologie, die LLMs mit Ihrem Unternehmenswissen verbindet. Und sie ist der Grund, warum Schweizer Unternehmen KI-Assistenten aufbauen können, die nicht nur klug klingen, sondern Antworten auf Basis interner, aktueller Daten geben — nachprüfbar an den mitgelieferten Quellen.
Was ist Retrieval-Augmented Generation (RAG)?
RAG ist ein Architekturmuster, das zwei Kernfähigkeiten kombiniert:
- Retrieval (Abruf): Relevante Informationen werden aus einer Wissensdatenbank abgerufen
- Augmented Generation (angereicherte Generierung): Diese Informationen werden dem LLM als Kontext übergeben, damit es präzise, faktenbasierte Antworten generiert
Das Problem ohne RAG
Ohne RAG hat ein LLM nur sein Trainingswissen – und das hat drei fundamentale Schwächen:
- Wissens-Cutoff: Das Modell kennt nur Daten bis zum Trainingsende. Aktuelle Informationen fehlen.
- Halluzinationen: Wenn das Modell die Antwort nicht kennt, erfindet es eine – überzeugend, aber falsch.
- Kein Unternehmenswissen: Interne Dokumente, Prozesse und Daten sind dem Modell unbekannt.
Die RAG-Lösung
RAG setzt an allen drei Schwächen an:
Nutzer-Frage: "Was ist unsere Rückgaberichtlinie für Premium-Kunden?"

OHNE RAG:
LLM generiert allgemeine Antwort → Wahrscheinlich falsch oder generisch

MIT RAG:
1. Frage wird in Vektor umgewandelt
2. Vektordatenbank findet relevante Dokumente (z.B. "Rückgaberichtlinie_2026.pdf")
3. Relevante Textpassagen werden dem LLM als Kontext übergeben
4. LLM generiert präzise Antwort basierend auf echten Unternehmensdaten
Das Ergebnis: Antworten, die auf aktuellen internen Dokumenten beruhen und über die mitgelieferten Quellen nachprüfbar sind. Halluzinationen werden dadurch stark reduziert — ausgeschlossen sind sie nicht, weshalb bei kritischen Auskünften eine menschliche Kontrolle dazugehört.
RAG-Architektur im Detail
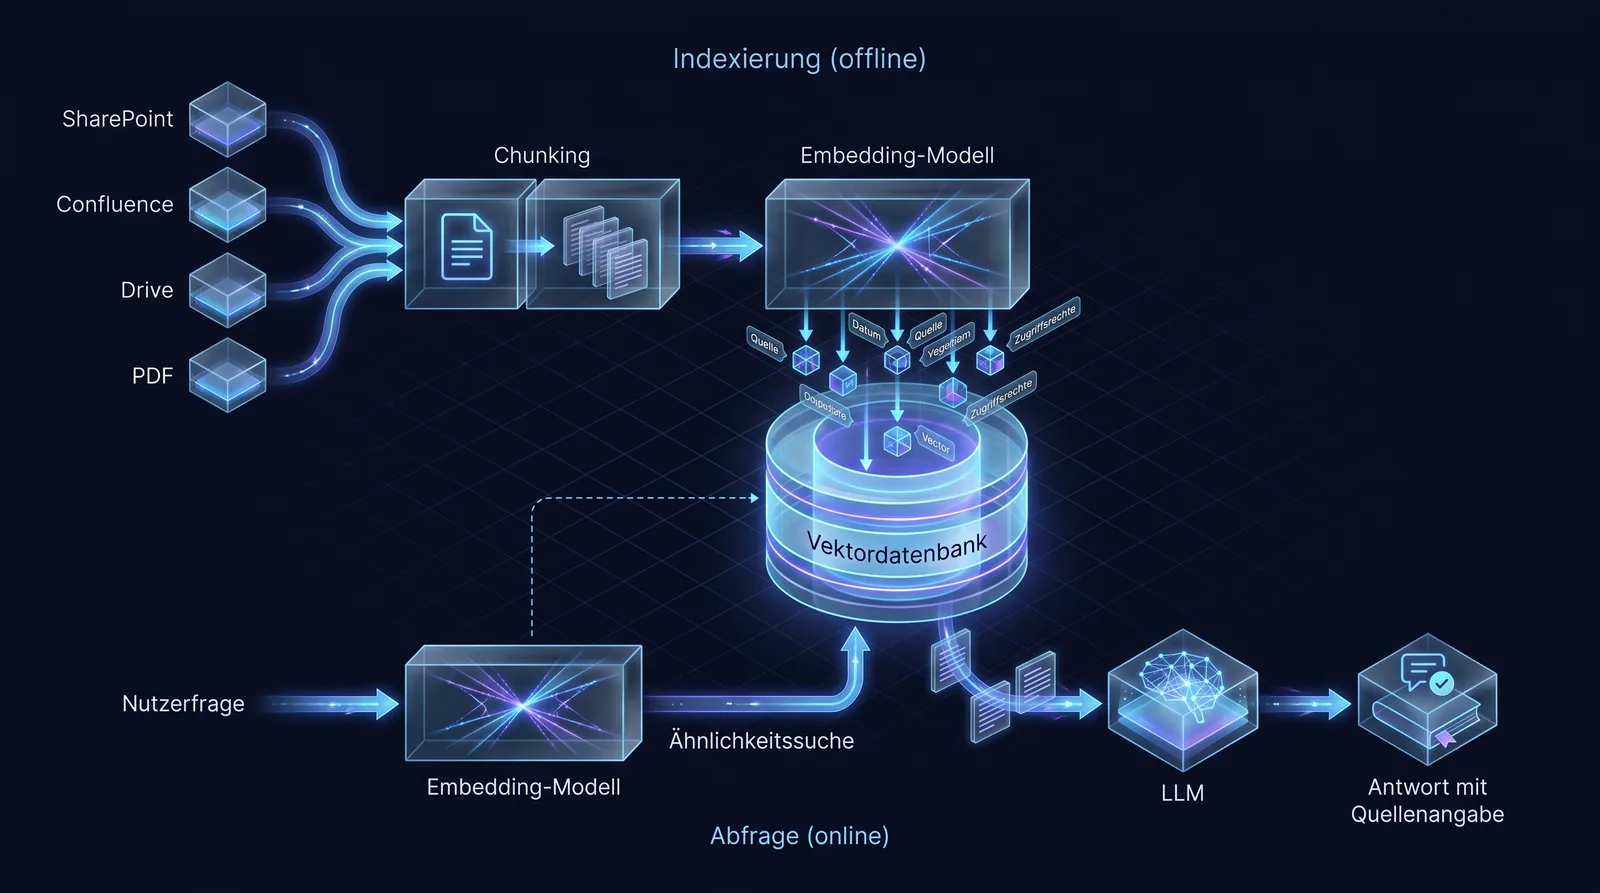
Eine RAG-Pipeline besteht aus zwei Hauptphasen: der Indexierung (Offline) und der Abfrage (Online).
Phase 1: Indexierung (Offline-Pipeline)
In dieser Phase werden Ihre Unternehmensdokumente für die späteren Abfragen vorbereitet:
Schritt 1: Datenquellen anbinden
Verbinden Sie Ihre Datenquellen – SharePoint, Confluence, Google Drive, CRM-Systeme, Datenbanken, PDFs, E-Mails. Eine gute RAG-Lösung kann mit verschiedensten Formaten umgehen.
Schritt 2: Chunking (Textsegmentierung)
Dokumente werden in sinnvolle Textabschnitte (Chunks) aufgeteilt. Die Chunking-Strategie ist entscheidend für die Qualität – dazu später mehr.
Schritt 3: Embedding-Generierung
Jeder Chunk wird durch ein Embedding-Modell in einen numerischen Vektor umgewandelt. Dieser Vektor repräsentiert die semantische Bedeutung des Textes.
Schritt 4: Speicherung in Vektordatenbank
Die Vektoren werden zusammen mit Metadaten (Quelle, Datum, Zugriffsrechte) in einer Vektordatenbank gespeichert.
Phase 2: Abfrage (Online-Pipeline)
Wenn ein Nutzer eine Frage stellt:
Schritt 1: Query Embedding
Die Nutzerfrage wird ebenfalls in einen Vektor umgewandelt.
Schritt 2: Ähnlichkeitssuche
Die Vektordatenbank findet die Chunks, deren Vektoren dem Query-Vektor am ähnlichsten sind (Cosine Similarity oder andere Distanzmetriken).
Schritt 3: Kontextaufbereitung
Die gefundenen Chunks werden als Kontext zusammengestellt und zusammen mit der Nutzerfrage an das LLM übergeben.
Schritt 4: Antwortgenerierung
Das LLM generiert eine Antwort basierend auf dem bereitgestellten Kontext und der ursprünglichen Frage.
Embedding-Modelle: Das Herzstück der semantischen Suche
Embedding-Modelle sind das Rückgrat jeder RAG-Architektur. Sie wandeln Text in dichte numerische Vektoren um, die semantische Ähnlichkeiten abbilden.
Wie Embeddings funktionieren
Stellen Sie sich vor, jedes Wort und jeder Satz erhält Koordinaten in einem hochdimensionalen Raum. Ähnliche Konzepte liegen nahe beieinander:
- "Rechnung" und "Faktura" → nahe beieinander (semantisch ähnlich)
- "Rechnung" und "Wetter" → weit voneinander entfernt
Auswahl des richtigen Embedding-Modells
| Modell | Dimensionen | Stärke | Einsatz |
|---|---|---|---|
| OpenAI text-embedding-3-large | 3'072 | Höchste Standarddimension der Reihe, breit einsetzbar | Enterprise, multilingual |
| OpenAI text-embedding-3-small | 1'536 | Gutes Preis-Leistungs-Verhältnis | Standard-Anwendungen |
| Cohere embed-v4.0 | 1'536 | Aktuelle Cohere-Generation, Text und Bild im selben Modell | Enterprise, gemischte Inhalte |
| Cohere embed-multilingual-v3.0 | 1'024 | Über 100 Sprachen | Multilingual, Deutsch |
| BGE-M3 (Open Source) | 1'024 | Multilingual, kostenlos | Self-hosted, Datenschutz |
| Jina Embeddings v3 | 1'024 | Flexibel, multilingual — von Jina als überholt gekennzeichnet | Forschung, spezialisiert |
Quelle der Dimensionen: OpenAI Embeddings-Doku («the length of the embedding vector isBei Cohere zeigt die Tabelle bewusst beide Generationen: embed-v4.0 als aktuelles Modell, daneben die weiterhin verfügbare v3.0-Reihe. Bei Jina steht nur eine Zeile: Jina kennzeichnet v3 als überholt und verweist auf jina-embeddings-v5-text-small — dieser Nachfolger ist in der Quellenzeile belegt, aber nicht als eigene Tabellenzeile geführt. Prüfen Sie vor der Auswahl, welche Generation der Anbieter zum Zeitpunkt Ihres Projekts führt.1536» für text-embedding-3-small, «3072fortext-embedding-3-large»), Cohere Embed-Doku (embed-v4.0 als «Latest Model» geführt, Dimensionen «One of [256, 512, 1024, 1536 (default)]»; embed-english-v3.0 und embed-multilingual-v3.0 je «1024» Dimensionen, letzteres für «over 100 languages, including Chinese, Spanish, and French»), BAAI/bge-m3 («BAAI/bge-m3 | 1024», MIT-Lizenz), jina-embeddings-v3 («Output Dimension: 1024», Lizenz «CC-BY-NC-4.0», Hinweis auf der Modellseite: «This model is deprecated by newer models», verwiesen wird auf jina-embeddings-v5-text-small — ebenfalls 1'024 Dimensionen und CC-BY-NC-4.0, veröffentlicht am 18. Februar 2026) — alle abgerufen am 24. August 2026. Genannt ist jeweils der Standardwert; mehrere dieser Modelle lassen sich auf kleinere Dimensionen kürzen. Achten Sie auf die Lizenz: BGE-M3 steht unter MIT und ist damit auch kommerziell frei einsetzbar, Jina Embeddings v3 unter CC BY-NC 4.0 — das schliesst den kommerziellen Eigenbetrieb der Gewichte aus.
Für Schweizer Unternehmen besonders relevant: Wenn Datenschutz kritisch ist (z. B. bei Finanzdaten oder Patientendaten), sollten Open-Source-Modelle wie BGE-M3 in Betracht gezogen werden, die lokal gehostet werden können.
Wichtig: Multilingual-Fähigkeit
Schweizer Unternehmen arbeiten oft mit Dokumenten in Deutsch, Französisch, Italienisch und Englisch. Wählen Sie ein Embedding-Modell mit starker multilingualer Performance, damit die semantische Suche sprachübergreifend funktioniert.
Vektordatenbanken: Wo das Wissen lebt
Vektordatenbanken sind spezialisierte Datenbanken, die für die Speicherung und schnelle Abfrage von Vektoren optimiert sind.
Die wichtigsten Vektordatenbanken im Vergleich
| Datenbank | Typ | Stärke | Listenpreis Cloud (USD) |
|---|---|---|---|
| Pinecone | Fully Managed | Einfachste Einrichtung, skalierbar | Starter gratis; Builder 20/Mt. pauschal; Standard ab 50/Mt. Mindestverbrauch |
| Weaviate | Open Source / Cloud | Hybrid-Suche, flexibel | Open Source; Cloud: Free, Flex ab 45/Mt., Premium ab 400/Mt. |
| Qdrant | Open Source / Cloud | Hohe Performance, Rust-basiert | Open Source; Cloud: Free Tier, Standard nutzungsbasiert (kein Listenpreis publiziert) |
| ChromaDB | Open Source / Cloud | Einfach, gut für Prototypen | Open Source; Cloud: Starter 0/Mt. plus Nutzung (5 USD Startguthaben), Team 250/Mt. plus Nutzung (100 USD Startguthaben) |
| pgvector (PostgreSQL) | Extension | Integration in bestehende DB | Bestehende DB-Kosten |
Quelle der Preise: Pinecone Pricing, Weaviate Pricing, Qdrant Pricing, Chroma Pricing — alle abgerufen am 24. August 2026. Die vier Anbieter fakturieren in US-Dollar; für einen Frankenbetrag kommen Wechselkurs und allfällige Gebühren hinzu. Preise ändern sich — prüfen Sie sie vor der Budgetierung am Original nach.
Entscheidungskriterien
- Skalierbarkeit: Wie viele Dokumente müssen indexiert werden? Tausende oder Millionen?
- Hosting: Cloud oder On-Premise? Für Schweizer Unternehmen mit Datenschutzanforderungen kann On-Premise wichtig sein.
- Integration: Passt die Datenbank in Ihren bestehenden Tech-Stack?
- Performance: Wie schnell müssen Abfragen beantwortet werden?
- Kosten: Managed Services sind einfacher, aber teurer.
Chunking-Strategien: Die Kunst der Textaufbereitung
Die Art, wie Sie Ihre Dokumente in Chunks aufteilen, hat enormen Einfluss auf die RAG-Qualität. Zu kleine Chunks verlieren Kontext, zu grosse Chunks verwässern die Relevanz.
Gängige Chunking-Methoden
Fixed-Size Chunking
Teilt Text in gleichgrosse Stücke (z. B. 500 Tokens) mit Überlappung (z. B. 50 Tokens). Einfach, aber nicht ideal für strukturierte Dokumente.
Semantic Chunking
Nutzt NLP, um semantisch zusammenhängende Abschnitte zu identifizieren. Besser für die Qualität, aber rechenintensiver.
Document-Structure-Based Chunking
Nutzt die Dokumentenstruktur (Überschriften, Absätze, Listen) als natürliche Trennpunkte. Ideal für gut strukturierte Dokumente.
Recursive Chunking
Versucht zunächst grosse semantische Einheiten zu bilden und teilt dann nur auf, wenn diese zu gross sind. Guter Kompromiss aus Qualität und Einfachheit.
Best Practices für Chunking
- Chunk-Grösse: 200-800 Tokens als Ausgangspunkt — ein Richtwert aus eigener Einschätzung, kein gemessener Optimalwert
- Überlappung: 10-20 % Überlappung verringern das Risiko, dass Kontext an Chunk-Grenzen verloren geht — ein Richtwert aus eigener Einschätzung für den Einstieg, kein gemessener Optimalwert
- Metadaten: Reichern Sie jeden Chunk mit Metadaten an (Dokumentname, Kapitel, Datum)
- Testen: Es gibt keine universelle beste Strategie – testen Sie verschiedene Ansätze mit Ihren spezifischen Daten
RAG vs. Fine-Tuning: Wann was sinnvoll ist
Eine häufige Frage: Sollte man RAG verwenden oder das LLM auf den eigenen Daten fine-tunen?
| Kriterium | RAG | Fine-Tuning |
|---|---|---|
| Datenaktualität | Stand des Index (Daten werden bei jeder Anfrage abgerufen) | Statisch (Stand des Trainings) |
| Kosten | Geringer (kein Modelltraining nötig) | Höher (GPU-Kosten für Training) |
| Implementierungszeit | Tage bis Wochen bis zur ersten Pipeline, Wochen bis Monate bis zur Produktion | Wochen bis Monate je Trainingslauf |
| Nachvollziehbarkeit | Hoch (Quellen zitierbar) | Niedrig (Black Box) |
| Datenvolumen | Skaliert mit der Vektordatenbank | Durch Trainingsdaten begrenzt |
| Flexibilität | Hoch (neue Daten sofort verfügbar) | Niedrig (Retraining nötig) |
| Halluzinationen | Stark reduziert | Teilweise reduziert |
Vertiefen Sie Ihr Wissen:Kombination: In vielen Fällen trägt eine Kombination aus RAG und leichtem Fine-Tuning weiter als eines der beiden allein — RAG liefert die Fakten, das Fine-Tuning den Stil.
- AI Agent Plattformen im Überblick
- Agentic Workflows für Unternehmen
- Multi-Agent-Systeme
- AI Automation Fallbeispiele Schweiz
- AI Agents vs Chatbots im Vergleich
- LangChain vs CrewAI im Vergleich
- Computer Use und Browser Automation
- Voice AI und Sprachassistenten
- Generative AI für Unternehmen
- Emerging LLMs für Automation
Enterprise RAG: Anforderungen und Best Practices
Die Implementierung von RAG in einem Unternehmenskontext bringt zusätzliche Anforderungen mit sich, die über ein einfaches Proof-of-Concept hinausgehen.
Zugriffskontrollen und Berechtigungen
In einem Unternehmen darf nicht jeder Mitarbeiter auf alle Informationen zugreifen. Enterprise RAG muss die bestehenden Zugriffsrechte respektieren:
- Document-Level Security: Nutzer sehen nur Ergebnisse aus Dokumenten, auf die sie Zugriff haben
- Role-Based Access Control (RBAC): Verschiedene Rollen sehen verschiedene Datenquellen
- Audit Logging: Jede Abfrage und jede zurückgegebene Quelle wird protokolliert
Datenqualität und -governance
- Aktualität: Stellen Sie sicher, dass die Indexierung regelmässig aktualisiert wird
- Deduplizierung: Vermeiden Sie redundante Dokumente, die die Ergebnisqualität mindern
- Metadaten-Anreicherung: Reichern Sie Dokumente mit Metadaten an, damit sich Ergebnisse gezielt filtern lassen
Evaluation und Monitoring
Messen Sie die Qualität Ihres RAG-Systems kontinuierlich:
- Retrieval-Qualität: Werden die richtigen Dokumente gefunden? (Recall, Precision)
- Antwortqualität: Sind die generierten Antworten korrekt und hilfreich?
- Latenz: Wie schnell erhält der Nutzer eine Antwort?
- Nutzerzufriedenheit: Feedback-Mechanismen einbauen
Advanced RAG-Techniken
Für fortgeschrittene Implementierungen gibt es weitere Techniken:
- Hybrid Search: Kombination aus semantischer Suche und Keyword-Suche für bessere Ergebnisse
- Reranking: Ein separates Modell bewertet die Relevanz der gefundenen Chunks nochmals
- Query Expansion: Die Nutzerfrage wird automatisch erweitert, um mehr relevante Ergebnisse zu finden
- Agentic RAG: AI Agents entscheiden dynamisch, welche Datenquellen abgefragt werden
Implementierungsleitfaden: RAG in 5 Schritten
Die Wochenangaben sind Richtwerte aus eigener Einschätzung für ein mittelgrosses Projekt, keine erhobenen Marktdaten. Zusammen ergeben sie die rund 16 Wochen bis zum produktionsreifen System, die oben im Antwortkasten stehen.
Schritt 1: Use Case definieren (Woche 1-2)
Identifizieren Sie einen konkreten Anwendungsfall mit klarem Mehrwert:- Interner Wissensassistent (HR-Richtlinien, IT-Support)
- Kundenservice-Bot mit Produktwissen
- Recherchetool für regulatorische Dokumente
Schritt 2: Daten vorbereiten (Woche 2-4)
- Inventarisierung relevanter Datenquellen
- Bereinigung und Strukturierung der Dokumente
- Definition der Chunking-Strategie
Schritt 3: Tech-Stack wählen (Woche 3-4)
- Embedding-Modell (z. B. OpenAI text-embedding-3-large)
- Vektordatenbank (z. B. Pinecone oder Weaviate)
- LLM (z. B. GPT-5.6, Claude Sonnet 5)
- Orchestrierung (z. B. LangChain, LlamaIndex)
Schritt 4: Prototyp bauen und testen (Woche 4-8)
- MVP implementieren
- Testen mit realen Fragen und Dokumenten
- Chunking und Retrieval-Parameter optimieren
Schritt 5: Produktion und Skalierung (Woche 8-16)
- Deployment in Produktionsumgebung
- Integration in bestehende Systeme
- Monitoring und kontinuierliche Verbesserung
- Prototyp: CHF 15'000-40'000
- Produktionsreifes System: CHF 50'000-150'000
- Enterprise-Lösung: CHF 100'000-300'000+
- Laufende Kosten: CHF 500-5'000/Monat (API-Kosten, Hosting)
FAQ: Häufig gestellte Fragen zu RAG
- Ist RAG sicher genug für vertrauliche Unternehmensdaten?
Wie sicher RAG ist, entscheidet nicht die Architektur, sondern Ihre Wahl der Bausteine. Massgeblich ist, wo Vektordatenbank, Embedding-Modell und LLM laufen: Nutzen Sie einen gehosteten Dienst wie Pinecone oder eine LLM-API, gehen die betroffenen Daten dorthin. Betreiben Sie Vektordatenbank, Embedding-Modell und ein offenes LLM selbst, bleibt die Bearbeitung auf Ihrer Infrastruktur — dann verlässt der Chunk-Inhalt das Unternehmen nicht. Zugriffskontrollen auf Dokumentenebene sorgen zusätzlich dafür, dass Nutzer nur Ergebnisse aus Dokumenten sehen, für die sie berechtigt sind. Self-Hosting entscheidet damit über den Bearbeitungsort und schafft die Voraussetzung für einen datenschutzkonformen Betrieb; Bearbeitungsgrundsätze, Informationspflicht, Betroffenenrechte, Bearbeitungsverzeichnis und Datensicherheit bleiben davon unberührt und liegen beim Unternehmen. Mehr zu Sicherheitsaspekten finden Sie in unserem AI Automation Guide.
- Wie unterscheidet sich RAG von einer normalen Suchmaschine?
Der fundamentale Unterschied liegt in der Antwortgenerierung. Eine Suchmaschine liefert Links zu relevanten Dokumenten – der Nutzer muss selbst lesen und interpretieren. RAG hingegen liest die relevanten Passagen, versteht den Kontext und generiert eine natürlichsprachige Antwort mit Quellenangaben. Das spart Lesezeit, besonders bei Fragen, deren Antwort über mehrere Dokumente verstreut liegt. RAG ist gewissermassen die Evolution von der Suche zur Antwort.
- Kann RAG mit mehrsprachigen Dokumenten umgehen?
Ja, moderne Embedding-Modelle wie OpenAI text-embedding-3-large oder Cohere embed-multilingual-v3.0 sind auf mehrsprachige Bestände ausgelegt. Das ist für Schweizer Unternehmen besonders wertvoll, da Dokumente oft in Deutsch, Französisch, Italienisch und Englisch vorliegen. Eine Frage auf Deutsch kann Ergebnisse aus französischen Dokumenten finden und die Antwort auf Deutsch generieren. Wichtig ist, bei der Auswahl des Embedding-Modells auf starke multilinguale Leistung zu achten und sie an den eigenen Dokumenten nachzumessen.
- Wie schnell veralten die Daten in einem RAG-System?
Die Aktualität hängt von Ihrer Indexierungsstrategie ab. Im Gegensatz zu Fine-Tuning, wo Daten beim Training eingefroren werden, kann RAG kontinuierlich aktualisiert werden. Üblich ist eine inkrementelle Indexierung: Neue oder geänderte Dokumente werden automatisch nachgezogen; in welchem Takt das geschieht, legen Sie selbst fest. Damit hängt die Aktualität an der Taktung Ihrer Indexierung, nicht am Trainingsstand des Modells. Weitere technische Details finden Sie in unserem AI Agents Guide.
Weiterführende Themen
Quellen
- Quelle der Dimensionen: OpenAI Embeddings-Doku («the length of the embedding vector is `1536`» für text-embedding-3-small, «`3072` for `text-embedding-3-large`»), Cohere Embed-Doku (embed-v4.0 als «Latest Model» geführt, Dimensionen «One of [256, 512, 1024, 1536 (default)]»; embed-english-v3.0 und embed-multilingual-v3.0 je «1024» Dimensionen, letzteres für «over 100 languages, including Chinese, Spanish, and French»), BAAI/bge-m3 («BAAI/bge-m3 | 1024», MIT-Lizenz), jina-embeddings-v3 («Output Dimension: 1024», Lizenz «CC-BY-NC-4.0», Hinweis auf der Modellseite: «This model is deprecated by newer models», verwiesen wird auf jina-embeddings-v5-text-small — ebenfalls 1'024 Dimensionen und CC-BY-NC-4.0, veröffentlicht am 18. Februar 2026) — alle abgerufen am 24. August 2026. Genannt ist jeweils der Standardwert; mehrere dieser Modelle lassen sich auf kleinere Dimensionen kürzen. Achten Sie auf die Lizenz: BGE-M3 steht unter MIT und ist damit auch kommerziell frei einsetzbar, Jina Embeddings v3 unter CC BY-NC 4.0 — das schliesst den kommerziellen Eigenbetrieb der Gewichte aus.
- Quelle der Preise: Pinecone Pricing, Weaviate Pricing, Qdrant Pricing, Chroma Pricing — alle abgerufen am 24. August 2026. Die vier Anbieter fakturieren in US-Dollar; für einen Frankenbetrag kommen Wechselkurs und allfällige Gebühren hinzu. Preise ändern sich — prüfen Sie sie vor der Budgetierung am Original nach.