Quelle der Anbieterpreise: LangSmith, Helicone, Weights & Biases, Datadog — abgerufen am 23. August 2026. Die Beträge stehen in der Währung des Anbieters; Anbieterpreise ändern sich.Der kritische Punkt bei AI Automation ist selten die Technologie selbst, sondern die Frage, ob jemand merkt, wenn sie im Betrieb aus dem Ruder läuft. Was in der Testphase funktioniert, kann im Produktivbetrieb unbemerkt falsche Ergebnisse liefern, unnötige Kosten verursachen oder Sicherheitslücken öffnen — und ohne Monitoring merkt es niemand. Für Schweizer Unternehmen, die AI Automation produktiv einsetzen, ist systematisches Monitoring deshalb keine Option – es ist eine Pflicht.
Dieser Guide zeigt Ihnen, wie Sie ein professionelles Monitoring für Ihre AI Agents und automatisierten Workflows aufbauen, welche KPIs wirklich zählen und welche Tools sich bewährt haben.
Warum Monitoring für AI Automation unverzichtbar ist
Klassische Software verhält sich deterministisch: Gleicher Input, gleicher Output. AI Agents sind anders. Sie arbeiten mit probabilistischen Modellen, deren Verhalten sich mit jedem API-Update, jedem Modellwechsel und jeder Änderung im Prompt subtil verändern kann.
Ohne Monitoring passiert Folgendes:
- Stille Fehler: Ein AI Agent liefert plausibel klingende, aber falsche Antworten – niemand merkt es
- Kostenexplosion: Ein schlecht optimierter Prompt verbraucht ein Vielfaches der nötigen Tokens
- Qualitätsdrift: Die Antwortqualität sinkt schleichend über Wochen
- Sicherheitslücken: Prompt Injections oder Datenlecks bleiben unentdeckt
- Compliance-Verstösse: Nachweispflichten gemäss nDSG können nicht erfüllt werden
Die 4 Säulen des AI Automation Monitorings
Ein ganzheitliches Monitoring-System ruht auf vier Säulen, die zusammen ein vollständiges Bild Ihrer AI-Operationen liefern.
Säule 1: Performance Monitoring
Performance Monitoring überwacht die technische Leistungsfähigkeit Ihrer AI-Systeme in Echtzeit.
Zentrale Metriken:
- Latenz (Response Time): Wie schnell antwortet der AI Agent? Als Zielwert setzen wir unter 3 Sekunden für interaktive Anwendungen und unter 30 Sekunden für Batch-Verarbeitung an — eine eigene Vorgabe, keine erhobene Marktzahl
- Durchsatz (Throughput): Wie viele Anfragen werden pro Minute/Stunde verarbeitet?
- Fehlerrate (Error Rate): Anteil fehlgeschlagener API-Aufrufe, Timeouts oder Abbrüche
- Verfügbarkeit (Uptime): Anteil der Zeit, in der das Gesamtsystem erreichbar ist (Zielvorgabe in diesem Guide: 99,5 % — selbst gesetzt, kein Anbieter-SLA)
- Queue-Länge: Wie viele Aufgaben warten in der Warteschlange?
| Metrik | Warning | Critical |
|---|---|---|
| Latenz | > 5 Sekunden | > 15 Sekunden |
| Fehlerrate | > 2 % | > 5 % |
| Verfügbarkeit | < 99,5 % | < 99 % |
| Queue-Länge | > 100 | > 500 |
Säule 2: Cost Tracking
API-Kosten können bei AI Automation schnell aus dem Ruder laufen. Ein strukturiertes Cost Tracking ist essenziell.
Was überwacht wird:
- Token-Verbrauch pro Agent: Input- und Output-Tokens getrennt erfassen
- Kosten pro Workflow-Ausführung: Was kostet ein einzelner Durchlauf in CHF?
- Tages-/Wochen-/Monatsbudgets: Automatische Alerts bei Budget-Überschreitung
- Kosten pro Ergebnis: Was kostet ein klassifiziertes Dokument, ein beantwortetes Ticket, eine Zusammenfassung?
- Modellvergleich: Welches Modell liefert das beste Preis-Leistungs-Verhältnis?
Säule 3: Quality Assurance
Die schwierigste, aber wichtigste Säule. Qualitäts-Monitoring stellt sicher, dass AI-Outputs korrekt und nützlich bleiben.
Qualitätsmetriken:
- Halluzinationsrate: Anteil der Antworten mit faktisch falschen Informationen
- Relevanz-Score: Wie gut passt die Antwort zur gestellten Frage?
- Konsistenz: Liefert der Agent bei ähnlichen Fragen ähnliche Antworten?
- User Satisfaction Score: Bewertung durch Endnutzer (Daumen hoch/runter, 1-5 Sterne)
- Eskalationsrate: Wie oft muss ein Mensch eingreifen?
- Automatisierte Stichproben mit Evaluations-Prompts
- Regelmässige manuelle Reviews einer Stichprobe — als Startwert etwa 5 % aller Outputs, bei hohem Schadenspotenzial mehr
- A/B-Tests bei Prompt-Änderungen
- Feedback-Loops von Endnutzern
Säule 4: Security Monitoring
Sicherheits-Monitoring schützt vor Missbrauch, Datenlecks und Angriffen auf Ihre AI-Systeme.
Überwachte Aspekte:
- Prompt Injection Detection: Erkennung von Manipulationsversuchen in User-Inputs
- Datenleck-Prävention: Enthält der Output vertrauliche Daten, die nicht nach aussen gelangen sollten?
- Zugriffsprotokollierung: Wer nutzt welchen Agent wann und wie oft?
- Rate Limiting: Schutz vor Missbrauch durch übermässige Nutzung
- Compliance-Logging: Lückenlose Protokollierung für AI Governance und Audits
KPIs für AI Agents: Was Sie messen müssen
Nicht jede Metrik ist für jedes Unternehmen gleich relevant. Hier die KPIs priorisiert nach Unternehmensreife:
Stufe 1 – Basis-KPIs (ab Tag 1):
- Verfügbarkeit und Fehlerrate
- API-Kosten pro Tag in CHF
- Anzahl verarbeiteter Anfragen
Stufe 2 – Operative KPIs (ab Monat 2):
- Durchschnittliche Latenz pro Agent
- Token-Verbrauch pro Workflow
- Eskalationsrate (Agent → Mensch)
- User Satisfaction Score
Stufe 3 – Strategische KPIs (ab Monat 6):
- Halluzinationsrate mit Trend
- ROI pro automatisiertem Prozess
- Qualitätsdrift über Zeit
- Kosten pro erfolgreichem Outcome
Tools für AI Monitoring & Observability
LangSmith
LangSmith von LangChain ist das führende Observability-Tool für LLM-basierte Anwendungen.
- Stärken: Trace-Analyse, Prompt-Versionierung, Evaluations-Framework, Playground
- Ideal für: Unternehmen mit eigenen AI Agents und komplexen LLM-Chains
- Kosten: Developer-Tier kostenlos (ein Sitz, bis 5'000 Base Traces pro Monat), Plus 39 USD je Sitz und Monat — jeweils zuzüglich nutzungsabhängiger Gebühren
Helicone
Helicone fokussiert auf Logging und Cost Tracking für API-basierte AI-Anwendungen.
- Stärken: Ein-Zeilen-Integration, detailliertes Cost Tracking, Request-Caching, Rate Limiting
- Ideal für: Teams, die schnell Transparenz über API-Kosten und -Nutzung brauchen
- Kosten: Hobby-Tier kostenlos mit 10'000 Requests pro Monat, Pro 79 USD pro Monat, Team 799 USD pro Monat
Weights & Biases (W&B)
Weights & Biases ist der Standard für ML-Experiment-Tracking und zunehmend auch für LLM-Monitoring.
- Stärken: Experiment-Tracking, Modellvergleiche, Team-Collaboration, umfangreiche Visualisierungen
- Ideal für: Data-Science-Teams mit eigenem Modelltraining oder Fine-Tuning
- Kosten: Free-Tier für einzelne Nutzerinnen und Nutzer, Pro ab 60 USD pro Monat
Datadog AI Monitoring
Datadog erweitert seine etablierte Infrastruktur-Monitoring-Plattform um spezifische AI-Observability-Features.
- Stärken: Integration mit bestehendem Infrastruktur-Monitoring, APM-Verknüpfung, Enterprise-ready
- Ideal für: Grössere Unternehmen mit bestehendem Datadog-Setup
- Kosten: Infrastructure Pro 15 USD je Host und Monat, Enterprise 23 USD (bei jährlicher Abrechnung); Agent Observability als eigenes AI-Produkt, abgerechnet über AI Credits ab 500 USD für 500 Credits pro Monat
Tool-Vergleich
| Kriterium | LangSmith | Helicone | W&B | Datadog |
|---|---|---|---|---|
| LLM-spezifisch | ★★★★★ | ★★★★☆ | ★★★☆☆ | ★★★☆☆ |
| Cost Tracking | ★★★☆☆ | ★★★★★ | ★★☆☆☆ | ★★★☆☆ |
| Einstiegshürde | Mittel | Niedrig | Hoch | Hoch |
| Enterprise-Ready | ★★★☆☆ | ★★★☆☆ | ★★★★☆ | ★★★★★ |
| Schweizer Hosting | Nein | Nein | Nein | EU-Region |
Alerting-Strategie: Wann der Agent eingreift, wann der Mensch
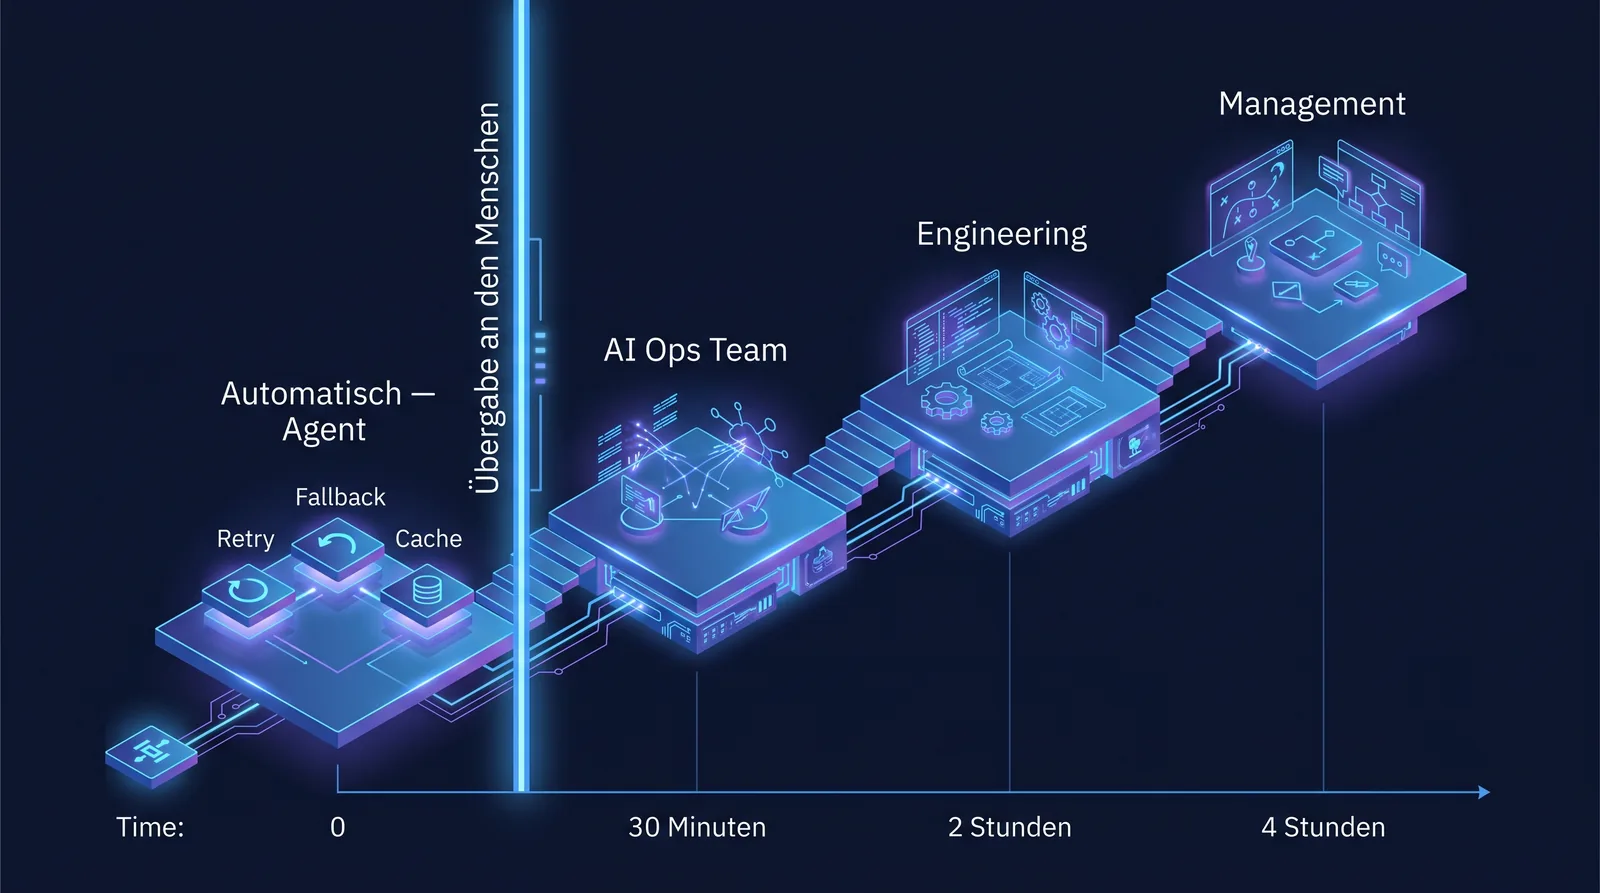
Eine durchdachte Alerting-Strategie unterscheidet zwischen Situationen, die automatisch behandelt werden können, und solchen, die menschliches Urteilsvermögen erfordern.
Automatische Agent-Reaktion (kein Mensch nötig)
Vertiefen Sie Ihr Wissen:
- Retry bei Timeout: API-Aufruf schlägt fehl → automatischer Retry mit Exponential Backoff
- Fallback-Modell: Primäres Modell nicht verfügbar → Wechsel auf Backup-Modell
- Cache-Nutzung: Ähnliche Anfrage bereits beantwortet → gecachte Antwort ausliefern
- Rate Limit: Nutzer überschreitet Limit → freundliche Warnung und Drosselung
- Budget-Warnung: 80 % des Tagesbudgets erreicht (selbst gesetzte Schwelle) → Wechsel auf günstigeres Modell
Menschliche Eskalation erforderlich
- Qualitätseinbruch: Halluzinationsrate steigt über 5 % (selbst gesetzte Schwelle, wie oben) → Alert an AI Operations Team
- Unbekannter Fehler: Neuer Fehlertyp, der nicht im Playbook steht → Eskalation an Entwickler
- Sicherheitsvorfall: Prompt Injection erkannt → sofortige Benachrichtigung Security Team
- Budget-Überschreitung: Das gesetzte Budget ist aufgebraucht → Manager-Freigabe für Weiterbetrieb
- Compliance-relevanter Vorfall: Potenzielles Datenleck → sofortige Eskalation an Datenschutzbeauftragten
Eskalationspfad
- Level 1 – Automatisch: Agent löst Problem selbst (Retry, Fallback, Cache)
- Level 2 – AI Ops Team: Alert via Slack/Teams, Reaktion innerhalb 30 Minuten
- Level 3 – Engineering: Technisches Problem, Reaktion innerhalb 2 Stunden
- Level 4 – Management: Budget- oder Compliance-Entscheid, Reaktion innerhalb 4 Stunden
Dashboard-Design: Was ein AI Operations Dashboard zeigen muss
Ein effektives AI Operations Dashboard gibt dem Team auf einen Blick alle Informationen, die es für operative Entscheide braucht.
Oberer Bereich: Status-Übersicht
- Gesamtstatus aller AI Agents (grün/gelb/rot)
- Aktive Workflows und deren aktueller Status
- Letzte 24 Stunden: Anfragen verarbeitet, Erfolgsrate, Durchschnittslatenz
Mittlerer Bereich: Trends und Metriken
- Kosten-Trend der letzten 7/30 Tage in CHF
- Qualitätsentwicklung (Satisfaction Score, Halluzinationsrate)
- Token-Verbrauch nach Agent aufgeschlüsselt
- Performance-Trend (Latenz, Durchsatz)
Unterer Bereich: Alerts und Actions
- Offene Alerts nach Priorität sortiert
- Letzte Eskalationen und deren Status
- Quick Actions (Agent pausieren, Budget anpassen, Modell wechseln)
Kosten-Monitoring: API-Kosten in CHF transparent machen
Eine der häufigsten Überraschungen bei AI Automation sind die laufenden API-Kosten. Transparentes Kosten-Monitoring macht die Entwicklung früh sichtbar, statt sie erst auf der Monatsrechnung erscheinen zu lassen.
Kostenstruktur pro Agent: Richtwerte für die eigene Planung
Die folgenden Bandbreiten sind Richtwerte aus eigener Einschätzung, keine erhobenen Marktdaten. Sie hängen an Modellwahl, Prompt-Länge und Anfragevolumen; die belastbare Zahl liefert erst das Cost Tracking des eigenen Betriebs.
| Agent-Typ | Kosten/Tag (CHF) | Kosten/Woche (CHF) | Kosten/Monat (CHF) |
|---|---|---|---|
| Einfacher Klassifikator | 0.50 – 2.00 | 3.50 – 14.00 | 15 – 60 |
| Kundensupport-Bot | 5.00 – 25.00 | 35 – 175 | 150 – 750 |
| Dokumenten-Analyse | 10.00 – 50.00 | 70 – 350 | 300 – 1'500 |
| Komplexer Research Agent | 20.00 – 100.00 | 140 – 700 | 600 – 3'000 |
Kosten-Optimierung durch Monitoring
- Prompt-Optimierung: Kürzere, präzisere Prompts senken den Token-Verbrauch — wie stark, zeigt der Vergleich der Token-Zähler vor und nach der Änderung
- Modell-Routing: Einfache Aufgaben an günstigere Modelle delegieren
- Caching: Wiederkehrende Anfragen cachen statt neu berechnen
- Batch-Verarbeitung: Anfragen bündeln für günstigere Batch-API-Preise
FAQ: AI Automation Monitoring
- Was kostet professionelles AI Monitoring?
Die Tools selbst starten bei null: LangSmith bietet ein kostenloses Developer-Tier, Helicone ein Hobby-Tier mit 10'000 Requests pro Monat. Wer darüber hinauswächst, zahlt Listenpreise von 39 USD je Sitz und Monat (LangSmith Plus), 79 USD pro Monat (Helicone Pro) oder ab 60 USD pro Monat (Weights & Biases Pro) — jeweils zuzüglich nutzungsabhängiger Gebühren, Stand 23. August 2026. Der grössere Aufwand liegt ohnehin nicht bei der Lizenz, sondern beim initialen Setup und der laufenden Pflege; wir rechnen dafür mit 2 bis 5 Tagen einmalig und 2 bis 4 Stunden pro Woche, das ist eine eigene Einschätzung und keine erhobene Marktzahl. Für KMU empfiehlt sich der Start mit einem Free Tier von LangSmith oder Helicone.
- Ab wann brauche ich Monitoring für meine AI Automation?
Ab dem Moment, in dem ein AI-Workflow in den Produktivbetrieb geht. Schon beim ersten produktiven Workflow sollten Sie mindestens Basis-KPIs wie Fehlerrate, Kosten und Verfügbarkeit tracken. Ein häufiger Fehler ist, Monitoring erst einzuführen, nachdem ein Problem aufgetreten ist – dann fehlen die historischen Daten zur Analyse. Die Implementierungs-Strategie sollte Monitoring von Anfang an einschliessen.
- Wie messe ich die Qualität von AI-Outputs?
Die Qualitätsmessung erfordert eine Kombination aus automatisierten und manuellen Methoden. Automatisiert können Sie Evaluations-Prompts einsetzen, die AI-Outputs gegen Referenzantworten prüfen. Ergänzend sollten regelmässige manuelle Stichproben durch Fachexperten erfolgen. User-Feedback (Daumen hoch/runter) liefert zusätzlich wertvolle Signale. Für Datenqualität als Basis guter Outputs gibt es separate Best Practices.
- Welches Monitoring-Tool soll ich als Schweizer KMU wählen?
Für den Einstieg empfehlen wir Helicone wegen der einfachen Integration und des starken Cost Trackings. Wenn Sie eigene AI Agents mit LangChain oder ähnlichen Frameworks bauen, ist LangSmith die bessere Wahl. Grössere Unternehmen mit bestehendem Datadog-Setup sollten deren AI Monitoring Add-on evaluieren. Wichtig: Die vier Säulen deckt keines der hier vorgestellten Werkzeuge allein ab – eine Kombination ist normal.
- Wie integriere ich Monitoring in bestehende Workflows?
Die meisten Monitoring-Tools bieten Proxy- oder Middleware-Integrationen, die zwischen Ihrem Code und dem API-Provider sitzen. Bei Helicone genügt oft eine Änderung der Base-URL im API-Aufruf. Bei LangSmith werden Callbacks in Ihre LangChain-Pipeline eingebaut. Für Make- oder n8n-Workflows können Sie Webhook-basierte Logging-Module ergänzen, die bei jeder Workflow-Ausführung Metriken an Ihr Dashboard senden.
Weiterführende Themen
Quellen
- Quelle der Anbieterpreise: LangSmith, Helicone, Weights & Biases, Datadog — abgerufen am 23. August 2026. Die Beträge stehen in der Währung des Anbieters; Anbieterpreise ändern sich.