Neben OpenAI (GPT-6 Astra, Sol und Luna), Anthropic (Claude Fable 5.1, Opus 5.5, Sonnet 5 und Haiku 4.5) und Google (Gemini 3.8 Flash, Gemini 3.1 Pro und die Flash-Lite-Stufen) bieten weitere Anbieter eigene Modell-APIs an – auf dieser Seite kurz Big 3 und Emerging LLMs. Eine belastbare Marktanteilszahl liegt uns für keine der beiden Gruppen vor. Die Emerging LLMs setzen bei Kontextlänge, Multimodalität oder offenen Gewichten eigene Schwerpunkte, teils zu niedrigeren Token-Preisen. Metas Muse Spark und Mistral Medium 3.5 behandeln wir im LLM-Vergleich, nicht hier.
Quelle: OpenAI · Anthropic · Google — abgerufen am 23. September 2026.Für Schweizer Unternehmen, die AI Automation implementieren, ist das strategisch relevant: Diversifizierung der LLM-Strategie reduziert Abhängigkeiten, senkt Kosten und eröffnet Zugang zu spezialisierten Fähigkeiten. Dieser Artikel analysiert vier Emerging LLMs und zeigt, wie eine Multi-Model-Architektur in der Praxis funktioniert.
Warum Diversifizierung der LLM-Strategie wichtig ist
Wer 2026 noch ausschliesslich auf ein einziges LLM setzt, geht unnötige Risiken ein:
- Preisänderungen: API-Preise können sich ändern – bei einem einzelnen Anbieter gibt es keine Alternative. Googles Flash-Preise etwa gelten nur bis zum 31. Dezember 2026 und verdoppeln sich danach
- Rate Limits: Unter hoher Last können APIs Rate Limits erreichen, die Automation-Workflows blockieren
- Ausfälle: Selbst die grössten Anbieter haben Downtime. Ohne Fallback steht die gesamte Automation still
- Spezialisierung: Kein einzelnes Modell passt auf jede Aufgabe. Ein Spezialist für Long Context (MiniMax-M3) kann bei dieser Aufgabe die bessere Wahl sein als ein Generalist
Kimi K3 (Moonshot AI)
Moonshot AI aus China führt Kimi K3 als «Kimi's most capable model to date» – mit 2,8 Billionen Parametern, nativem Bildverständnis und 1 Mio. Token Kontext, ausgelegt laut Anbieter auf Software-Entwicklung, Wissensarbeit und tiefes Reasoning. Kimi K3 kostet 3 USD ein und 15 USD aus je 1 Mio. Token, gecachte Eingaben 0.30 USD. Die früheren Fassungen kimi-k2.5 und die moonshot-v1-Serie hat Moonshot AI am 31. August 2026 eingestellt, die kimi-k2-Serie bereits am 25. Mai 2026; wer sie noch fest in Workflows verdrahtet hat, muss umstellen.
Stärken von Kimi K3
- 1 Mio. Token Context Window: für die Verarbeitung langer Dokumente, Verträge und umfangreicher Datensätze
- 2,8 Billionen Parameter: laut Anbieter das leistungsfähigste Modell der Reihe
- Reasoning-Fokus: vom Anbieter für tiefes Reasoning ausgelegt
- Weitere Stufen: kimi-k2.7-code für Programmieraufgaben und kimi-k2.6 für Text- und Bildeingaben, je mit 256K Kontext
Einsatz in AI Automation
Kimi K3 eignet sich als Spezialist für Aufgaben, die langes Kontextverständnis und mehrstufiges Schlussfolgern erfordern: Vertragsanalyse, Dokumentenvergleich, komplexe Datenextraktion und mehrstufige Reasoning-Chains in Agentic Workflows. Mit 3 USD Eingabe liegt Kimi K3 preislich über Claude Sonnet 5 und GPT-6 Sol (je 2 USD) – ein Spargrund ist es also nicht.
MiniMax-M3
MiniMax-M3 (seit 1. Juni 2026) beschreibt der Anbieter als «Frontier multimodal coding model with 1M context window», ausgelegt auf agentisches Reasoning, Tool Use, Programmierung, multimodale Chat-Eingaben und lange Kontexte. Das auffälligste Merkmal ist das Context Window von 1 Million Tokens: Ganze Bücher, umfangreiche Codebases oder Tausende von Dokumenten passen in einen einzigen Kontext. In der Standard-Stufe kostet MiniMax-M3 0.30 USD ein und 1.20 USD aus je 1 Mio. Token bis 512'000 Eingabe-Token – der Anbieter weist das als dauerhaft um 50 % reduzierten Listenpreis von 0.60 / 2.40 aus. Eine Parameterzahl nennen die geprüften Anbieterseiten nicht. Die offizielle Schreibweise der Reihe ist MiniMax-M2.5, -M2.7 und -M3; die Kurzform «MiniMax 2.7» kommt in der Anbieterdokumentation nicht vor.
Stärken von MiniMax-M3
- 1 Mio. Token Context Window: Sehr grosses Kontextfenster – geeignet für Ultra-Long-Context-Aufgaben
- Multimodale Eingabe: multimodale Chat-Eingaben ohne separates Modell
- Niedriger Token-Preis: 0.30 / 1.20 USD je 1 Mio. Token in der Standard-Stufe
- Vorgängerstufen weiterhin verfügbar: MiniMax-M2.7 und -M2.5 mit je 204'800 Token Kontext
Einsatz in AI Automation
MiniMax-M3 passt überall dort, wo extrem langer Kontext oder multimodale Eingaben benötigt werden: Analyse grosser Dokumentensammlungen, Verarbeitung von Screenshots und Bildern in Automation-Workflows. Für Schweizer Unternehmen, die Dokumenten-Automation mit gemischten Medien betreiben, ist MiniMax-M3 eine Speziallösung, die sich zu testen lohnt.
Grok 4.7 (xAI)
Grok 4.7 von xAI ist das aktuelle Spitzenmodell der Reihe; der Anbieter nennt es «Our flagship model for code and everything else» und «the most capable model we've built». Auf x.ai und in der Entwicklerdokumentation tritt der Anbieter inzwischen als SpaceXAI auf. Der Vorgänger Grok 4.6 bleibt zum selben Preis im Katalog, die früheren Grok-3-Modelle stehen nicht mehr in der Preisliste.
Stärken von Grok 4.7
- 500'000 Token Kontext: laut xAI-Modellübersicht, Wissensstand Mai 2026
- Gestaffelter Preis: 2 USD ein und 6 USD aus je 1 Mio. Token unter 200'000 Token, darüber 4 und 12 USD; gecachte Eingaben 0.50 USD
- Anbindung an X über X Search: Das Werkzeug durchsucht Beiträge und Profile auf X per Stichwort, semantisch und nach Nutzern – zu 5 USD je 1'000 abgerufene Beiträge und 10 USD je 1'000 Profile, zusätzlich zu den Token-Kosten
- Konfigurierbares Reasoning: laut xAI-Modellübersicht einstellbar
Einsatz in AI Automation
Grok 4.7 ist für Automation-Workflows interessant, die aktuelle Informationen von X benötigen: Social-Media-Monitoring, Trendanalyse, Marktbeobachtung und News-Aggregation. Wichtig ist dabei die Einschränkung, die xAI selbst nennt: Ohne aktivierte Suchwerkzeuge (Web Search oder X Search) kennt Grok nur seine Trainingsdaten, keine aktuellen Ereignisse.
Einschränkung: Die Suchkosten fallen je abgerufenem Beitrag an und summieren sich bei Monitoring-Workflows schnell; kalkulieren Sie sie zusätzlich zu den Token-Kosten und validieren Sie die Ausgaben, bevor sie in Unternehmensprozesse fliessen.
DeepSeek-V4
Die DeepSeek-Reihe wurde bereits im Artikel zu Open-Source LLMs behandelt und verdient hier eine Erwähnung als Emerging LLM, da sie die Grenzen zwischen Open-Source und proprietär verwischt. Über die DeepSeek-API laufen derzeit deepseek-v4-pro (Modellversion DeepSeek-V4-Pro-0813) und deepseek-flash (DeepSeek-V4.1-Flash); das ältere R1 steht dort nicht mehr im Katalog. Der frühere Name deepseek-v4-flash wird noch angenommen, das zugehörige Modell ist aber abgeschaltet – solche Anfragen beantwortet laut DeepSeek inzwischen DeepSeek-V4.1-Flash. Die Gewichte von DeepSeek-V4-Pro, V4-Flash und V4.1-Flash liegen unter MIT-Lizenz offen.
Stärken von DeepSeek-V4
- MIT-Lizenz: kommerzielle Nutzung, Veränderung und Weitergabe erlaubt; der Lizenz- und Copyright-Hinweis muss erhalten bleiben
- Self-Hosting möglich: Die Verarbeitung bleibt in der eigenen Infrastruktur
- 1 Mio. Token Kontext, 384K Token Ausgabe: für lange Dokumente und ausführliche Antworten
- Modellgrössen: DeepSeek-V4-Pro mit 1,6 Billionen Parametern (49 Mrd. aktiv), DeepSeek-V4-Flash mit 284 Mrd. (13 Mrd. aktiv); DeepSeek-V4.1-Flash baut auf einem 552-Mrd.-Backbone auf und verarbeitet auch Bilder
- API verfügbar: Auch als Cloud-API nutzbar, mit Preisen nach Tageszeit – ausserhalb der Spitzenzeiten kostet
deepseek-v4-pro0.66 USD ein und 1.98 USD aus je 1 Mio. Token,deepseek-flash0.15 und 0.60 USD; in der Spitzenzeit gilt jeweils das Doppelte
Einsatz in AI Automation
DeepSeek-V4 bietet sich für die Reasoning-Komponente in einer Multi-Model-Architektur an: komplexe Entscheidungslogik in AI Agents und mehrstufige Analysen. Durch die MIT-Lizenz und die Self-Hosting-Option kommt es besonders für datenschutzkritische Anwendungen in der Schweiz in Frage.
Vergleichstabelle: Emerging LLMs
| Modell | Anbieter | Parameter | Context Window | Input / Output je 1 Mio. Token | Stärken | Verfügbarkeit |
|---|---|---|---|---|---|---|
| Kimi K3 | Moonshot AI | 2,8 Bio. | 1'048'576 | 3.00 / 15.00 USD | Reasoning, Long Context, Bildverständnis | API |
| MiniMax-M3 | MiniMax | keine Angabe | 1 Mio. | 0.30 / 1.20 USD (bis 512K Eingabe) | Multimodal, Ultra-Long-Context | API |
| Grok 4.7 | xAI | keine Angabe | 500'000 | 2.00 / 6.00 USD (<200K), 4.00 / 12.00 USD (≥200K) | X Search, Code | API (xAI) |
| DeepSeek-V4-Pro | DeepSeek | 1,6 Bio. (49 Mrd. aktiv) | 1 Mio. | 0.66 / 1.98 USD (Off-Peak) | Offene Gewichte, Self-Hosting, MIT | API + Self-Hosted |
| DeepSeek-V4.1-Flash | DeepSeek | 552 Mrd. Backbone | 1 Mio. | 0.15 / 0.60 USD (Off-Peak) | Offene Gewichte, Bildeingabe, MIT | API + Self-Hosted |
| Modell | Ein | Aus | Kontextfenster |
|---|---|---|---|
| GPT-6 Astra (OpenAI) | 10.00 | 50.00 | 1,05 Mio. |
| GPT-6 Sol (OpenAI) | 2.00 | 10.00 | 1,05 Mio. |
| GPT-6 Luna (OpenAI) | 0.10 | 0.50 | 1,05 Mio. |
| Claude Fable 5.1 (Anthropic) | 10.00 | 50.00 | 1 Mio. |
| Claude Opus 5.5 (Anthropic) | 4.00 | 20.00 | 1 Mio. |
| Claude Sonnet 5 (Anthropic) | 2.00 | 10.00 | 1 Mio. |
| Claude Haiku 4.5 (Anthropic) | 1.00 | 5.00 | 200'000 |
| Gemini 3.1 Pro, Preview (Google) | 2.00 | 12.00 | 1'048'576 |
| Gemini 3.8 Flash, bis 31.12.2026 (Google) | 0.75 | 3.75 | 1'048'576 |
| Gemini 3.5 Flash-Lite (Google) | 0.30 | 2.50 | 1'048'576 |
Google weist die Preise je Modell aus; die Flash-Sätze von 3.8, 3.7 und 3.6 gelten bis 31. Dezember 2026 und verdoppeln sich ab 1. Januar 2027 auf 1.50 / 7.50 USD. Bei Gemini 3.8 Flash und 3.5 Flash-Lite gilt der Eingabepreis auch für Audio. Die Vorgängermodelle GPT-5.6, Claude Fable 5 und Claude Opus 5 bleiben verfügbar. Umgerechnet zum EZB-Referenzkurs vom 22. September 2026 (1 USD = 0.8194 CHF) entspricht 1 USD rund 0.82 CHF – diese CHF-Werte sind Umrechnungen, keine Anbieterpreise.
Quelle: OpenAI · Anthropic · Google — abgerufen am 23. September 2026.
Multi-Model-Architektur: Die optimale LLM-Strategie
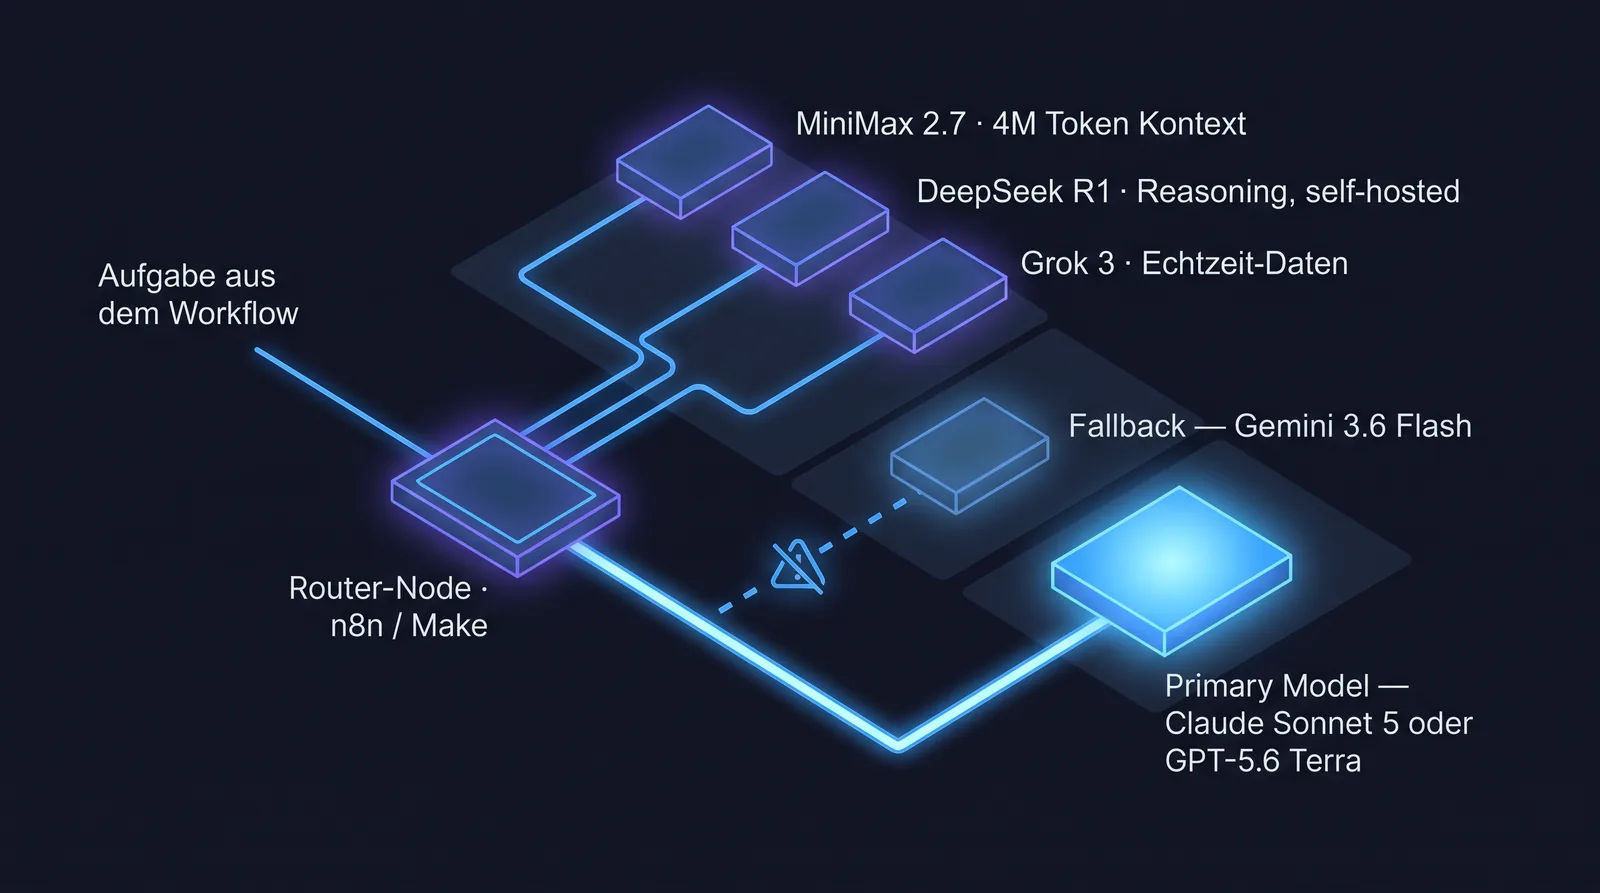
Statt sich auf ein einziges Modell zu verlassen, empfehlen wir eine geschichtete Multi-Model-Architektur:
Vertiefen Sie Ihr Wissen:
Schicht 1: Primary Model (Hauptmodell)
Das Modell, das die Kernaufgaben trägt. Empfehlung: Claude Sonnet 5 oder GPT-6 Sol – je nach Vergleichsergebnis für den spezifischen Use Case.
Einsatz: Komplexe Reasoning-Aufgaben, kundennahe Kommunikation, kritische Entscheidungen.
Schicht 2: Fallback Model
Ein Alternativmodell, das bei Ausfall oder Rate Limits des Primary Models einspringt. Empfehlung: Gemini 3.8 Flash oder das jeweils andere der Big-3-Modelle.
Einsatz: Automatischer Wechsel bei API-Fehlern, Rate Limits oder Downtime.
Schicht 3: Spezialist
Ein oder mehrere spezialisierte Modelle für spezifische Aufgaben. Empfehlungen:
- Long Context: MiniMax-M3 oder Kimi K3 für Dokumente jenseits des Kontextfensters des Primary Models
- Reasoning: DeepSeek-V4-Pro für komplexe Logik-Aufgaben
- Echtzeit-Daten: Grok 4.7 mit X Search für Aufgaben mit aktuellem Informationsbedarf
- High-Volume: DeepSeek-V4.1-Flash über die API oder selbst betrieben für kostengünstige Massenverarbeitung
Implementierung
In Automation-Plattformen wie n8n oder Make lässt sich eine Multi-Model-Architektur über Router-Nodes umsetzen: Ein Entscheidungsknoten analysiert die Aufgabe und leitet sie an das passende Modell weiter. Bei Fehlern wird automatisch auf das Fallback-Modell gewechselt.
Risikomanagement: Vendor Lock-in vermeiden
Vendor Lock-in bei LLMs hat konkrete Risiken:
Strategische Massnahmen
- Standardisierte Prompts: Prompts so schreiben, dass sie mit minimalen Anpassungen auf verschiedenen Modellen funktionieren. Modellspezifische Syntax vermeiden.
- Abstraktionsschicht: Eine eigene API-Schicht zwischen Automation-Workflows und LLM-Anbietern einziehen. Bei Anbieterwechsel muss nur die Abstraktionsschicht angepasst werden, nicht jeder Workflow.
- Regelmässiges Benchmarking: Vierteljährlich die Performance und Kosten der eingesetzten Modelle gegen Alternativen benchmarken. Der LLM-Markt entwickelt sich schnell – Google etwa hat Gemini 3.6, 3.7 und 3.8 Flash am 21. Juli, 13. August und 2. September 2026 veröffentlicht.
- Open-Source-Komponente: Mindestens einen Teil der LLM-Nutzung auf Open-Source-Modelle stützen. Selbst betriebene Gewichte kann kein Anbieter abschalten oder verteuern.
- Vertragsgestaltung: Bei Enterprise-Verträgen mit LLM-Anbietern auf Preisgarantien, SLAs und Exit-Klauseln achten.
Häufig gestellte Fragen
- Sind Emerging LLMs zuverlässig genug für produktive AI Automation?
Für spezifische Aufgaben ja. Kimi K3, MiniMax-M3, Grok 4.7 und DeepSeek-V4 bieten produktiv nutzbare APIs. Achten Sie dabei auf die Modellpflege: Moonshot AI hat kimi-k2.5 und die moonshot-v1-Serie am 31. August 2026 eingestellt, xAI führt Grok 3 nicht mehr, DeepSeek bietet R1 nicht mehr über die API an und beantwortet Anfragen an
deepseek-v4-flashinzwischen mit einem anderen Modell — ein fest verdrahteter Modellname wird so zum Ausfallgrund oder zur stillen Verhaltensänderung. Für unternehmenskritische Kernprozesse empfehlen wir jedoch weiterhin die Big 3 als Primary Model und Emerging LLMs als Spezialisten oder Fallback. Eine hybride Strategie kombiniert das Beste aus beiden Welten.- Wie integriere ich mehrere LLMs in einen Automation-Workflow?
In n8n nutzen Sie einen Switch-Node, der basierend auf Aufgabentyp, Token-Länge oder Fehlercode das passende Modell auswählt. In Make funktioniert das über Router-Module. DeepSeek etwa dokumentiert ein zu OpenAI und Anthropic kompatibles API-Format; bei solchen Anbietern reicht oft ein Wechsel der Base-URL und des API-Keys. Prüfen Sie die Kompatibilität für jeden Anbieter in dessen Dokumentation.
- Was kostet eine Multi-Model-Strategie im Vergleich zu einem einzelnen LLM?
Oft weniger. Durch den gezielten Einsatz günstiger Modelle für einfache Aufgaben (z.B. DeepSeek-V4.1-Flash für Klassifikation) und teurer Modelle nur für komplexe Aufgaben (z.B. Claude Opus 5.5 für anspruchsvolle Agentenläufe) sinken die Gesamtkosten gegenüber der Nutzung eines einzigen Premium-Modells für alles. Wie stark, hängt vom Aufgabenmix ab und lässt sich nur mit den eigenen Volumen durchrechnen.
- Gibt es Datenschutzbedenken bei chinesischen LLM-Anbietern?
Wohin Daten fliessen und was der Anbieter damit tut, steht in den jeweiligen API-Bedingungen und unterscheidet sich je Anbieter und Tarif; pauschale Konformitätsaussagen machen wir hier keine. Belegbar ist die Stufen-Unterscheidung bei Google: In der kostenlosen Stufe der Gemini-API nutzt Google die Inhalte zur Produktverbesserung, in der kostenpflichtigen nicht. Wer die Verarbeitung ganz in der eigenen Hand behalten will, betreibt ein Modell mit offenen Gewichten wie DeepSeek-V4 selbst; sonst trennt man sensible von nicht-sensiblen Aufgaben und prüft die Datenflüsse vorab gegen das Schweizer Datenschutzgesetz (nDSG) und die eigenen Vorgaben zu datenschutzkritischen Anwendungen.
Quelle: Google — abgerufen am 23. September 2026.
- Welches Emerging LLM ist der beste Geheimtipp für Schweizer KMU?
DeepSeek-V4: Die Gewichte stehen unter MIT-Lizenz und lassen sich self-hosted betreiben, womit die Verarbeitung in der eigenen Infrastruktur bleibt. Vergleichende Leistungsaussagen gegenüber den Big 3 lassen wir weg – belegbar sind sie nicht. Für Schweizer KMU, die AI Automation kosteneffizient implementieren wollen, ist DeepSeek-V4 als Ergänzung zu einem Primary Model wie Claude Sonnet 5 eine pragmatische Wahl.