Die AI-Automation-Landschaft hat sich verändert. Während Unternehmen 2024 noch überwiegend auf proprietäre APIs von OpenAI, Anthropic oder Google zurückgriffen, stehen 2026 Open-Source LLMs zur Verfügung, die sich für viele Automationsaufgaben einsetzen lassen – bei voller Datenkontrolle und ohne laufende API-Kosten.
Für Schweizer Unternehmen, die AI Automation implementieren, ist das eine strategische Chance: Open-Source-Modelle ermöglichen Automation-Workflows, bei denen keine Daten das eigene Netzwerk verlassen. Doch die Entscheidung zwischen Open-Source und proprietär ist komplex – und hängt vom konkreten Use Case ab.
Warum Open-Source LLMs für AI Automation relevant sind
Drei Entwicklungen machen Open-Source LLMs 2026 zu einer ernsthaften Option für produktive AI Automation:
1. Modellreife: Modelle wie Llama 4, Mistral Large 3, DeepSeek-V4 und Gemma 4 lassen sich für strukturierte Aufgaben wie Datenextraktion, Zusammenfassung und Code-Generierung einsetzen; ob sie im eigenen Anwendungsfall genügen, zeigt ein Test mit eigenen Daten.
2. Infrastruktur-Reife: Werkzeuge wie Ollama, vLLM und SGLang vereinfachen das Deployment offener Modelle. Mit Ollama startet ein lokales Modell mit einem einzigen Befehl, etwa ollama run gemma4.
3. Regulatorische Anforderungen: Das Schweizer Datenschutzgesetz (nDSG) regelt, unter welchen Bedingungen Personendaten an Auftragsbearbeiter (Art. 9) und ins Ausland (Art. 16) bekanntgegeben werden dürfen; branchenspezifische Vorgaben kommen hinzu. Im eigenen Rechenzentrum betriebene LLMs vermeiden diese Bekanntgabe für die Modellverarbeitung; wer die Gewichte bei einem Cloud-Anbieter betreibt, hat es weiterhin mit einem Auftragsbearbeiter zu tun.
Offene LLMs von fünf Anbietern 2026
Llama 4 und Muse Glimmer (Meta)
Meta führt mit Llama 4 zwei Modelle mit offenen Gewichten, beide nativ multimodal und als Mixture of Experts gebaut: Llama 4 Scout (109 Mrd. Parameter, davon 17 Mrd. aktiv, 10 Mio. Token Kontext) und Llama 4 Maverick (400 Mrd., davon 17 Mrd. aktiv, 1 Mio. Token Kontext). Beide erschienen am 5. April 2025, ihr Wissensstand reicht bis August 2024. Die Modellkarte nennt zwölf unterstützte Sprachen, darunter Deutsch, Französisch und Italienisch. Die Llama 4 Community License ist keine von der Open Source Initiative anerkannte Open-Source-Lizenz: Wer am Release-Datum über 700 Millionen monatlich aktive Nutzer hatte, muss eine gesonderte Lizenz bei Meta beantragen, und Produkte müssen «Built with Llama» sichtbar ausweisen – für Schweizer KMU ist vor allem die Kennzeichnungspflicht relevant.
Neuer ist Muse Glimmer, laut Meta «An open model built for always-on local agents»: 30 Mrd. Parameter, unter Apache 2.0 und laut Anbieter auf einer einzelnen GPU lauffähig. Metas aktuelles Spitzenmodell Muse Spark ist dagegen nur per API verfügbar und hat keine offenen Gewichte.
Stärken: breites Ökosystem, zwölf unterstützte Sprachen bei Llama 4, sehr langer Kontext bei Scout, freizügige Apache-2.0-Lizenz bei Muse Glimmer.
Mistral Large 3 und Medium 3.5 (Mistral AI)
Das französische Unternehmen Mistral AI bietet zwei grosse Modelle mit offenen Gewichten an. Mistral Large 3 ist laut Anbieter ein «open-weight, general-purpose multimodal model» mit Mixture-of-Experts-Architektur: 675 Mrd. Parameter, davon 41 Mrd. aktiv, 256'000 Token Kontext, unter Apache 2.0. Mistral Medium 3.5 (seit 28. April 2026) beschreibt Mistral als «frontier-class multimodal model optimized for agentic and coding use cases»; die Gewichte stehen unter einer modifizierten MIT-Lizenz, der Kontext umfasst ebenfalls 256'000 Token. Wer Mistral über die API statt selbst betreibt, hat mit Mistral AI einen Anbieter mit Sitz in der EU – beim Self-Hosting spielt die Herkunft der Gewichte für den Bearbeitungsort dagegen keine Rolle.
Stärken: europäischer Anbieter für die API-Nutzung, Apache 2.0 bei Large 3, multimodale Eingabe, 256'000 Token Kontext.
DeepSeek-V4
Die aktuelle DeepSeek-Reihe heisst V4 und steht unter MIT-Lizenz – sie erlaubt kommerzielle Nutzung, Veränderung und Weitergabe und verlangt nur, dass der Lizenzhinweis erhalten bleibt. Die Gewichte liegen in drei Fassungen vor: DeepSeek-V4-Pro (1,6 Bio. Parameter, davon 49 Mrd. aktiv), DeepSeek-V4-Flash (284 Mrd., davon 13 Mrd. aktiv) und DeepSeek-V4.1-Flash (552-Mrd.-Backbone, verarbeitet auch Bilder), alle mit 1 Mio. Token Kontext. Über die DeepSeek-API laufen deepseek-v4-pro und deepseek-flash; Details zu Preisen und Modellnamen stehen im Überblick über neue LLM-Anbieter. Das ältere DeepSeek R1 wird über die DeepSeek-API nicht mehr angeboten; wer es self-hosted betreibt, sollte den Wechsel auf V4 einplanen.
Stärken: MIT-Lizenz, Reasoning-Ausrichtung, 1 Mio. Token Kontext, zusätzlich als günstige API verfügbar.
Qwen3.8 (Alibaba)
Die aktuelle offene Generation von Alibabas Qwen-Reihe ist Qwen3.8 (August 2026) mit dem Mixture-of-Experts-Modell Qwen3.8-2.4T-A95B und dem dichten Qwen3.8-27B. Qwen3.8-27B steht laut Modellkarte unter Apache 2.0 und verarbeitet nativ 262'144 Token, erweiterbar auf 1'000'000. In Ollama ist es als quantisierte Fassung mit 18 GB verfügbar und nimmt Text und Bilder entgegen. Die älteren Qwen-3-Modelle bleiben herunterladbar.
Stärken: laut Anbieter Schwerpunkt auf Coding und agentischen Aufgaben, Bild- und Videoverständnis, Apache 2.0 beim 27B-Modell, lokal lauffähig in quantisierter Form.
Gemma 4 (Google)
Googles Gemma 4 erscheint in fünf Grössen: den Edge-Modellen E2B und E4B («effective» 2 bzw. 4 Mrd. Parameter) für Laptops und Mobilgeräte sowie den Workstation-Modellen 12B, 26B A4B (Mixture of Experts, 3,8 Mrd. Parameter aktiv) und 31B (dicht). Die kleinen Modelle fassen 128'000 Token Kontext, die mittleren 256'000. Alle verarbeiten Text und Bilder, E2B und E4B zusätzlich Audio. Anders als Gemma 3 steht Gemma 4 unter der Apache-2.0-Lizenz, nicht unter der eigenen Gemma-Lizenz. Das 26B-A4B-Modell braucht nach Googles Speichertabelle 57,7 GB in 16 Bit, 28,8 GB in 8 Bit und 14,4 GB in 4 Bit (nur Gewichte).
Stärken: Grössen vom Smartphone bis zur Workstation, Audio-Eingabe bei den Edge-Modellen, Apache-2.0-Lizenz.
Vergleichstabelle: Open-Source LLMs
| Modell | Parameter | Context Window | Lizenz | Stärken | Hardware laut Anbieter |
|---|---|---|---|---|---|
| Llama 4 Maverick | 400B (MoE, 17B aktiv) | 1M Tokens | Llama 4 Community License | Ökosystem, 12 Sprachen | FP8: ein H100-DGX-Host |
| Llama 4 Scout | 109B (MoE, 17B aktiv) | 10M Tokens | Llama 4 Community License | Sehr langer Kontext | int4: eine H100 |
| Muse Glimmer | 30B | keine Angabe | Apache 2.0 | Lokale Agenten | eine GPU |
| Mistral Large 3 | 675B (MoE, 41B aktiv) | 256K Tokens | Apache 2.0 | Multimodal, europäisch | Multi-GPU-Server |
| Mistral Medium 3.5 | keine Angabe | 256K Tokens | Modified MIT | Agenten, Coding | keine Angabe |
| DeepSeek-V4-Pro | 1,6 Bio. (MoE, 49B aktiv) | 1M Tokens | MIT | Reasoning | Multi-GPU-Server |
| DeepSeek-V4-Flash | 284B (MoE, 13B aktiv) | 1M Tokens | MIT | Kleinere V4-Stufe | Multi-GPU-Server |
| Qwen3.8-27B | 27B | 262K Tokens (bis 1M) | Apache 2.0 | Coding, Bild und Video | quantisiert 18 GB (Ollama) |
| Gemma 4 | E2B–31B | 128K / 256K Tokens | Apache 2.0 | Edge bis Workstation | 26B A4B: 14,4 GB in 4 Bit |
Self-Hosting Setup: Drei Wege zum eigenen LLM
Ollama – Lokal auf dem Desktop
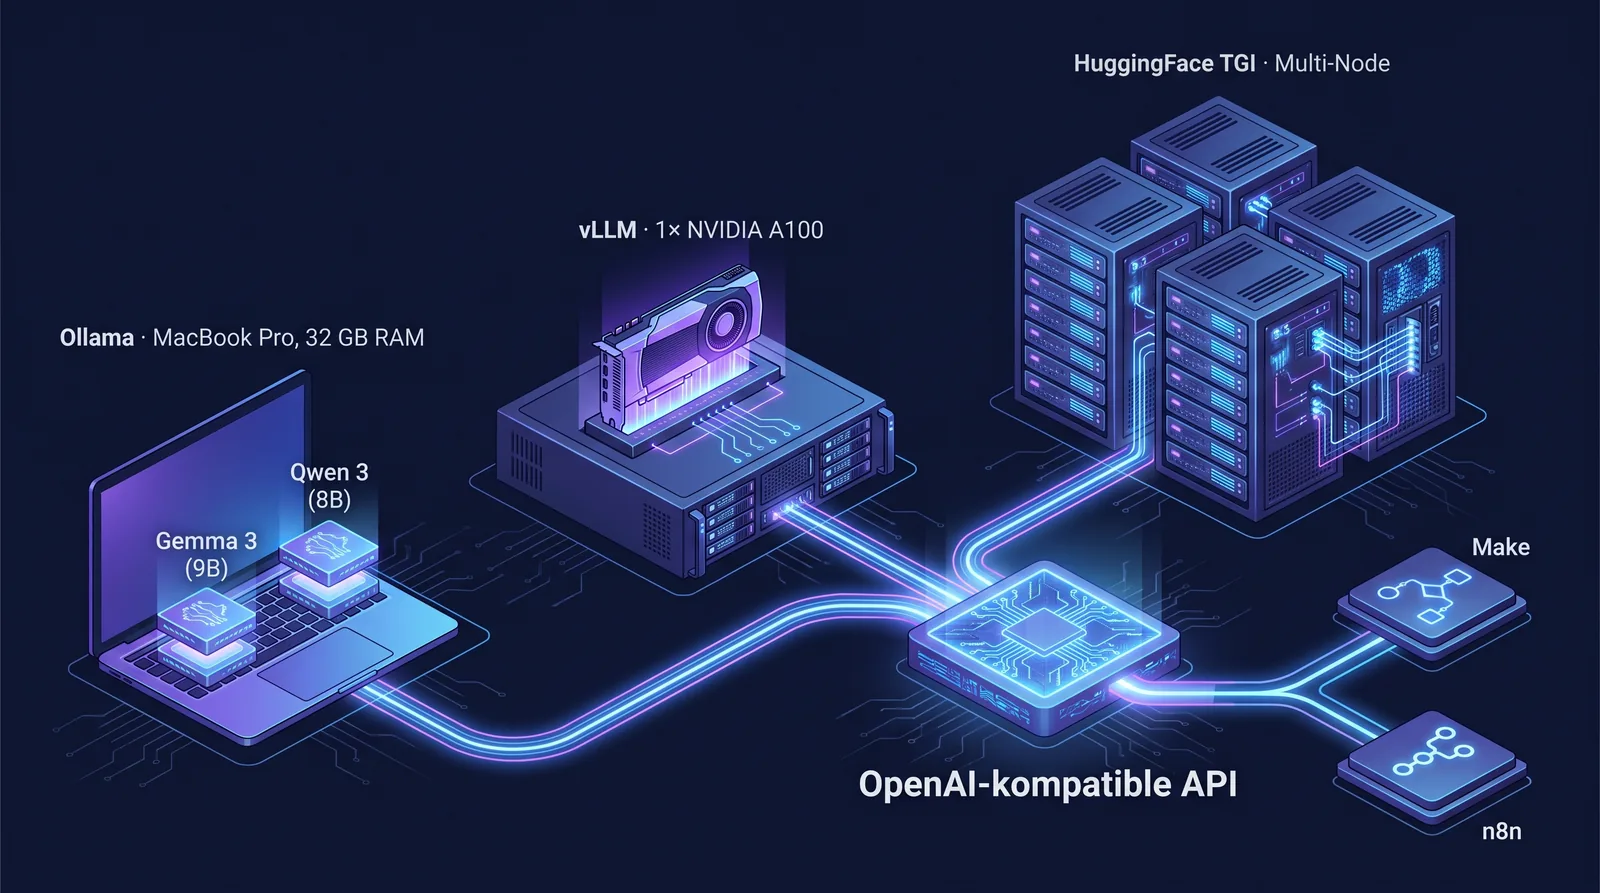
Ollama ist der einfachste Weg, ein Open-Source LLM lokal zu betreiben. Nach der Installation startet ein Modell mit einem Befehl, etwa ollama run gemma4. Ollama liefert die Modelle in vorquantisierten Fassungen – Gemma 4 12B etwa mit 7,6 GB, Qwen3.8-27B mit 18 GB – und bietet eine REST-API, die direkt in Automation-Workflows eingebunden werden kann.
Geeignet für: Entwicklung, Prototyping, kleine Teams, datenschutzkritische Desktop-Automation.
Hardware: Für Modelle bis etwa 18 GB Download (Gemma 4 12B, Qwen3.8-27B) reicht ein MacBook Pro mit 32 GB RAM. Für grössere Modelle wird eine dedizierte GPU empfohlen.
vLLM – Produktiver Server-Betrieb
vLLM ist ein Inference-Server für den produktiven Betrieb von LLMs. Er nutzt PagedAttention für die Speicherverwaltung und Continuous Batching für hohen Durchsatz.
Geeignet für: Produktive Workloads, mehrere gleichzeitige Anfragen, API-Server für das gesamte Unternehmen.
Hardware: Rechenzentrums-GPUs wie die NVIDIA A100 (40 oder 80 GB) im Beispiel; wie viele es sein müssen, bestimmt die Modellgrösse. Für grössere Modelle braucht es Multi-GPU-Setups.
SGLang – Grosse und verteilte Deployments
SGLang ist ein Serving-Framework, das laut Projekt «from a single GPU to large distributed clusters» ausgelegt ist – mit Continuous Batching, Paged Attention, Quantisierung sowie Tensor-, Pipeline- und Expert-Parallelisierung. Es ist mit den meisten Hugging-Face-Modellen und mit OpenAI-APIs kompatibel.
Geeignet für: Enterprise-Deployment, sehr grosse Mixture-of-Experts-Modelle, Teams mit ML-Engineering-Erfahrung.
Hardware: Vergleichbar mit vLLM, zusätzlich ausgelegt auf verteilte Cluster. Das früher verbreitete Text Generation Inference (TGI) von HuggingFace ist im Wartungsmodus; HuggingFace verweist dort selbst auf vLLM, SGLang sowie für lokale Setups auf llama.cpp und MLX.
Vorteile von Open-Source LLMs für AI Automation
Datenschutz und nDSG-Compliance
Der grösste Vorteil für Schweizer Unternehmen: Bei Self-Hosted LLMs verlassen keine Daten die eigene Infrastruktur. Für datenschutzkritische Branchen wie Finanz, Pharma oder Gesundheitswesen ist das oft eine Grundvoraussetzung. Self-Hosting entscheidet damit über den Bearbeitungsort und schafft die Voraussetzung für eine nDSG-konforme Bearbeitung. Die übrigen Pflichten des Schweizer Datenschutzgesetzes (nDSG) — Bearbeitungsgrundsätze, Informationspflicht, Betroffenenrechte, Bearbeitungsverzeichnis und Datensicherheit — gelten unabhängig vom Betriebsort weiter.
Keine laufenden API-Kosten
Cloud-APIs berechnen pro Token. Bei High-Volume-Automation mit Tausenden von Anfragen pro Tag summieren sich diese Kosten schnell. Ein Self-Hosted LLM hat fixe Hardware-Kosten, aber keine variablen Kosten pro Anfrage. Ab einem gewissen Volumen ist Self-Hosting günstiger.
Volle Kontrolle und Anpassbarkeit
Open-Source-Modelle können fine-getuned, quantisiert und auf spezifische Use Cases optimiert werden. Unternehmen sind nicht von Feature-Updates oder Preisänderungen eines API-Anbieters abhängig.
Offline-Betrieb
Self-Hosted LLMs funktionieren ohne Internetverbindung. Für Produktionsumgebungen, Feldarbeit oder Air-Gapped-Netzwerke ist das ein entscheidender Vorteil.
Nachteile und Herausforderungen
Hardware-Anforderungen
Leistungsfähige LLMs benötigen dedizierte GPU-Hardware. Für eine NVIDIA A100 mit 80 GB VRAM rechnen wir nach eigener Schätzung mit ab CHF 15'000; ein Listenpreis ist das nicht. Cloud-GPU-Instanzen (z.B. bei AWS, Azure oder Schweizer Anbietern) sind eine Alternative, reduzieren aber den Datenschutz-Vorteil.
Wartung und Betrieb
Self-Hosting bedeutet eigene Verantwortung: Updates, Monitoring, Skalierung, Backup. Unternehmen benötigen DevOps-Kompetenz oder einen spezialisierten Partner.
Leistung bei komplexen Aufgaben
Ob ein offenes Modell bei sehr komplexem Reasoning, kreativem Schreiben oder nuancierten Konversationen mit Modellen wie Claude oder GPT-6 mithält, hängt vom Modell und von der Aufgabe ab; eine belastbare, allgemeine Rangfolge führen wir hier nicht auf. Für strukturierte Automation-Aufgaben lohnt der Test mit eigenen Daten, bevor Sie sich für eine Seite entscheiden.
Vertiefen Sie Ihr Wissen:
Keine Garantie und kein SLA
Open-Source-Modelle kommen ohne Service Level Agreement. Bei Problemen ist die Community die erste Anlaufstelle – professioneller Support ist nur über Drittanbieter verfügbar.
Self-Hosted vs Cloud API: Der direkte Vergleich
| Dimension | Self-Hosted Open-Source | Cloud API (GPT-6, Claude, Gemini) |
|---|---|---|
| Datenschutz | Maximal – Daten bleiben intern | Abhängig vom Anbieter (EU/US) |
| Kosten (niedrig Volumen) | Hoch (Hardware-Investition) | Günstig (Pay-per-Token) |
| Kosten (hohes Volumen) | Günstig (fixe Kosten) | Teuer (skaliert linear) |
| Leistung | modell- und aufgabenabhängig, im eigenen Test prüfen | modell- und aufgabenabhängig, im eigenen Test prüfen |
| Wartung | Eigene Verantwortung | Keine (managed) |
| Latenz | Ohne Netzwerkweg, abhängig von der eigenen Hardware | Abhängig von Netzwerk und Anbieter |
| Skalierung | Manuell (mehr GPUs) | Automatisch |
| Verfügbarkeit | Eigene Infrastruktur | Zugesichert per SLA, je Dienst und Modell unterschiedlich |
| Anpassbarkeit | Volle Kontrolle (Fine-Tuning) | Begrenzt (System Prompts) |
Break-Even-Berechnung
Als Richtwert aus eigener Einschätzung — keine erhobenen Marktdaten — liegt der Break-Even für Self-Hosting bei ungefähr 500'000–1'000'000 API-Calls pro Monat. Darunter ist eine Cloud-API meist wirtschaftlicher, darüber spart Self-Hosting. Wo die Schwelle im Einzelfall liegt, hängt von Modellgrösse, durchschnittlicher Antwortlänge und Auslastung der Hardware ab; rechnen lässt sie sich nur mit den eigenen Token-Volumen. Beachten Sie dabei, wie tief die günstigsten API-Stufen inzwischen liegen: GPT-6 Luna kostet 0.10 USD je 1 Mio. Eingabe-Token, die DeepSeek-API ausserhalb der Spitzenzeiten 0.15 USD.
Wann Open-Source LLMs sinnvoll sind
Open-Source empfohlen bei:
- Datenschutzkritischen Anwendungen (Finanz, Gesundheit, Recht)
- Hohem Anfragevolumen (>500K Anfragen/Monat)
- Offline- oder Air-Gapped-Umgebungen
- Bedarf an Fine-Tuning auf eigene Daten
- Wunsch nach Unabhängigkeit von einem einzelnen Anbieter
Cloud-API empfohlen bei:
- Niedrigem bis mittlerem Volumen
- Bedarf an den stärksten verfügbaren Modellen für komplexe Aufgaben
- Fehlendem DevOps-Know-how
- Schnellem Prototyping und MVP-Entwicklung
- Bedarf an garantierter Verfügbarkeit (SLA)
Hybride Strategie: Viele Unternehmen kombinieren beide Ansätze – Cloud-API für komplexe Aufgaben und Open-Source LLMs für High-Volume-Standard-Aufgaben. AI Agents können automatisch das passende Modell wählen.
Häufig gestellte Fragen
- Kann ich ein Open-Source LLM auf einem normalen Laptop betreiben?
Ja, aber mit Einschränkungen. Gemma 4 12B (7,6 GB) oder Qwen3.8-27B (18 GB) laufen in den quantisierten Ollama-Fassungen auf einem MacBook Pro mit 32 GB RAM; die Edge-Modelle Gemma 4 E2B und E4B sind ausdrücklich für Laptops und Mobilgeräte gebaut. Für grössere Modelle wie Llama 4 oder DeepSeek-V4 wird dedizierte GPU-Hardware benötigt. Für produktive Automation-Workflows empfehlen wir mindestens eine Workstation mit NVIDIA RTX 4090 (24 GB) oder besser – darauf passt etwa Gemma 4 26B A4B in 4 Bit mit 14,4 GB.
- Sind Open-Source LLMs wirklich kostenlos?
Die Modelle selbst sind kostenlos herunterladbar. Die Kosten entstehen durch Hardware (GPU-Server oder Cloud-GPU-Instanzen), Strom und Wartung. Für ein produktives Setup mit einer NVIDIA A100 rechnen wir nach eigener Schätzung mit Investitionen ab CHF 15'000 für Hardware plus CHF 200–500/Monat für Strom und Wartung; Cloud-GPU-Instanzen kosten ab ca. CHF 2–4 pro Stunde. Das sind Richtwerte, keine Listenpreise.
- Wie steht es um die Qualität im Vergleich zu ChatGPT oder Claude?
Für strukturierte Aufgaben – Datenextraktion, Zusammenfassung, Klassifikation, Code-Generierung – lassen sich offene Modelle produktiv einsetzen. Eine allgemeine Prozentzahl für den Abstand zu proprietären Modellen wäre geraten: «Qualität» heisst je nach Aufgabe etwas anderes, und die Rangfolge ändert sich mit jeder Modellgeneration. Verlässlich ist nur ein Vergleich mit den eigenen Daten und einer festen Bewertungsvorlage. Für typische AI-Automation-Workflows ist das der Weg zur Entscheidung.
- Welches Open-Source LLM eignet sich am besten für Schweizer Unternehmen?
Es gibt kein universell bestes Modell. Für mehrsprachige Aufgaben (Deutsch, Französisch, Italienisch) testen Sie die Kandidaten mit eigenen Texten; Llama 4 nennt diese drei Sprachen ausdrücklich unter seinen zwölf unterstützten. Für Reasoning-intensive Automation bietet sich DeepSeek-V4 an, für Edge-Deployment und lokale Nutzung Gemma 4. Wer bei Meta bleiben will, wählt Llama 4 oder – mit der freizügigeren Apache-2.0-Lizenz – Muse Glimmer.
- Kann ich Open-Source LLMs in Make oder n8n integrieren?
Ja. Sowohl Make als auch n8n unterstützen HTTP-Requests an beliebige APIs. Ein via Ollama, vLLM oder SGLang betriebenes Open-Source-LLM stellt eine OpenAI-kompatible API bereit, die direkt in Automation-Workflows eingebunden werden kann. In n8n gibt es zusätzlich native Ollama-Nodes für die einfache Integration.
Quellen
Modellnamen, Parametergrössen, Kontextlängen und Lizenzangaben folgen den Anbieterquellen: Meta (Llama-4-Modellkarte, Llama 4 Community License, Muse Glimmer), Mistral (Large 3, Medium 3.5), DeepSeek (Preise und die Modellkarten auf Hugging Face für V4-Pro, V4-Flash und V4.1-Flash), Qwen (GitHub, Qwen3.8-27B), Google (Gemma, Apache 2.0 für Gemma); Downloadgrössen aus der Ollama-Bibliothek (Gemma 4, Qwen3.8); zu den Servern SGLang und TGI («text-generation-inference is now in maintenance mode») — alle abgerufen am 23. September 2026. Die Bezeichnung «Open Source» verwenden mehrere dieser Anbieter für Modelle mit Nutzungsbeschränkungen; wo das zutrifft, ist es im Text benannt. Alle Kostenangaben in CHF sind Richtwerte aus eigener Schätzung für typische Betriebszuschnitte, keine Listenpreise und keine eigenen Messwerte.